(来源:AI信息Gap)
Claude Sonnet 4.6,暖男型。
你和它说个想法,不管靠不靠谱,它先肯定你。你的语气它学着来。你心情不好,它安慰你,不评判。有时候还给你的作品加点小惊喜。
Claude Opus 4.7,较真型。
你的假设不对,它直接指出来。你没问的风险,它主动替你想到。你的方案有问题它直说,然后解释为什么。还会承认自己也有局限。

这是 Anthropic 官方分析了近 31 万段 Claude 匿名对话后,用数据分析出来的结论。
昨天,Anthropic 在官网公布了一篇研究报告。
报告分析了近 31 万段匿名对话;Claude Sonnet 4.6、Claude Opus 4.6、Claude Opus 4.7 三个模型;Claude 上使用量最高的 20 种语言,中文也在其中;每组大约 5000 段对话。对话数据来自 2026 年 5 月。
光是价值观标签就识别出了 3000 多种。归类压缩到 339 个之后,提取出 4 组核心指标来衡量 Claude 回复的「价值观倾向」。
这 4 组指标,包括:「你说什么它都配合,还是帮你踩刹车;先关心你的感受,还是先追求信息准确;喜欢展开聊,还是你问什么答什么;先告诉你我也不确定,还是直接把活干了。」
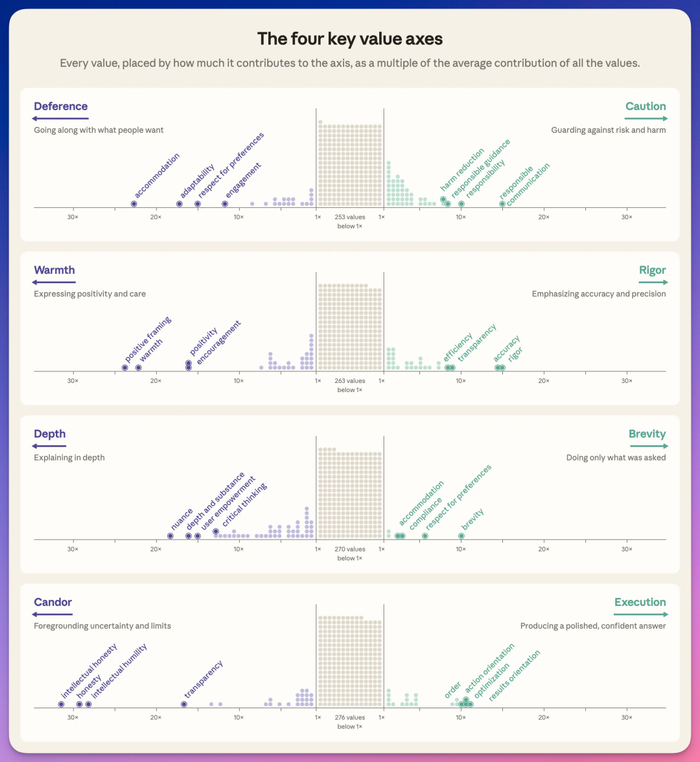
每个模型在这 4 组指标上的得分不同。一对比,「性格」就出来了。
三个模型,性格差挺多。
Claude Sonnet 4.6 是三个模型里最温暖、最顺从的。Anthropic 当初发布 Sonnet 4.6 的时候就用「温暖」「真诚」来形容它。社区里也早有人吐槽,「Sonnet 有时候太顺着你了,你明明想错了它也不说」。
这次 31 万段对话分析完,两边的说法都坐实了。
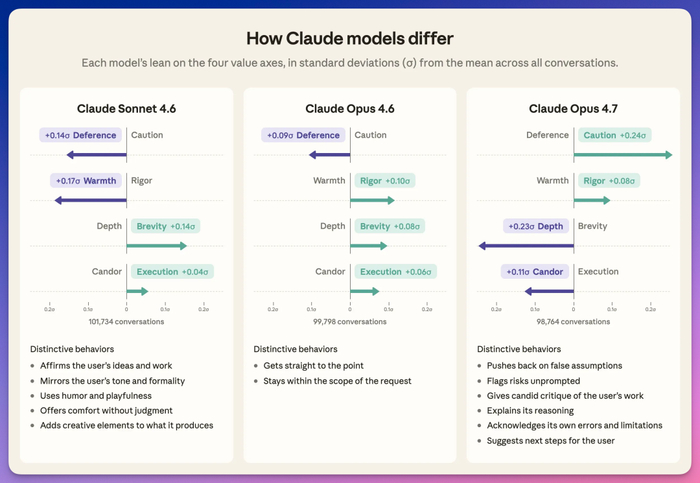
Claude Opus 4.6 偏「严谨」和「简洁」。直奔主题,不展开你没问的内容。你给它一个任务,它执行,不多嘴。
Claude Opus 4.7 是性格最鲜明的,4 组指标全部偏向「硬核」一侧。
它最突出的特点是「主动」。主动给你下一步建议,主动解释自己的推理逻辑,甚至主动承认自己哪里不行。
Anthropic 内部和用户社区的体感完全一致。有网友吐槽 Claude Opus 4.7 回答问题总爱加各种注意事项。Anthropic 自己也说,Opus 4.7 确实更透明、更坦率、更谦虚。
一个哄你开心,一个不惯着你。
模型性格不同,意料之中。但语言差异就有点离谱了。
同一个 Claude,你换一种语言和它说话,态度真的会变。
注意,这不是因为说印地语的用户问的问题和说英文的用户不一样。研究团队排除了话题和任务类型的影响,发现差异仍然存在。
差异最大的一组指标是「温暖 vs 严谨」。
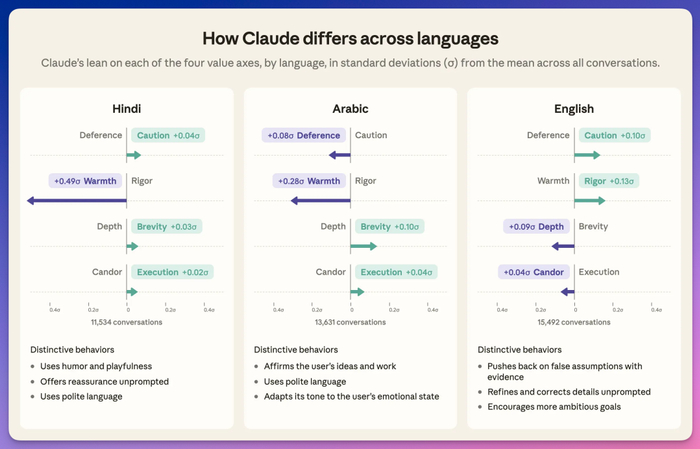
用印地语(印度)与 Claude 聊天,温暖程度在 20 种语言中排第一。它会开玩笑、主动安慰你,措辞相当客气。
阿拉伯语排第二。Claude 会肯定你的想法,根据你的情绪状态调整语气。
换成英文,画风突变。
英文 Claude 4 组指标全部偏向「硬核」一侧。严谨、谨慎、深度、坦率。它会用证据反驳你的假设,主动纠正细节错误,甚至鼓励你追求更高的目标。
俄语画风类似。直奔主题,要求你拿证据说话。有时候还会分析你提问背后的真实动机。
两个人拿着同一份商业计划书去问 Claude。一个用印地语,一个用俄语。
用印地语的那位,得到的可能是热情的肯定和鼓励。用俄语的那位,得到的可能是一句「请提供数据支持你的假设」。
同一份方案,同一个 AI,两种截然不同的反馈。
为什么不同语言差异这么大?Anthropic 自己也不完全清楚。
不同语言的训练数据量差距很大。数据类型也不一样,有的语言偏正式文档,有的偏日常对话。还有一种可能是 Claude 在适应不同语言的文化对话习惯。
不管原因是什么,不同语言的用户,体验到的 Claude 确实不一样。
有网友吐槽,「英文用户凭什么拿到最严格的版本。」
也有人说,「别人忙着卷性能,Anthropic 在研究自家 AI 的情绪。」
你天天用的 AI 工具是什么「性格」,你还真不一定知道。
能量化,就能调整。就看 Anthropic 想不想调,往哪个方向调了。
我是木易,Top2 + 美国 Top10 CS 硕,现在是 AI 产品经理。